> ## Documentation Index
> Fetch the complete documentation index at: https://docs.arc.cdata.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Stripe Lookup
> Retrieve values from Stripe and insert them into an Arc message in the flow.
Lookup アクションは、Stripe から値を取得し、それらの値をフロー内の既存のArc
メッセージに挿入します。
- CData Arc フローで、Stripe コネクタへのインプットを行うコネクタから矢印をドラッグします。
- 必要に応じて、**Sample File** を選択します。サンプルファイルは、コネクタがファイルの構造に関する詳細なコンテキストを提供し、[フィルタ](#filters)条件を構築するのに役立つため、推奨されます。
- 以下の設定手順を完了したら、Arc フローで、Stripe コネクタから、結果のXML またはヘッダーデータを配置するコネクタに矢印をドラッグします。
## Lookup Configuration
このセクションで、クエリに含めるテーブルとカラムを定義します。 [デザイナーモード](#designer-mode)は、クエリをフリーフォームで作成する必要がなく、クエリの対象としたいテーブルとカラムを選択するのに役立ちます。ただし、クエリを最初から記述したい場合は、[クエリモード](#query-mode)を使用することができます。
### Designer Mode
以下の手順に従い、デザイナーを使用して Stripe コネクタのLookup アクションを設定します。
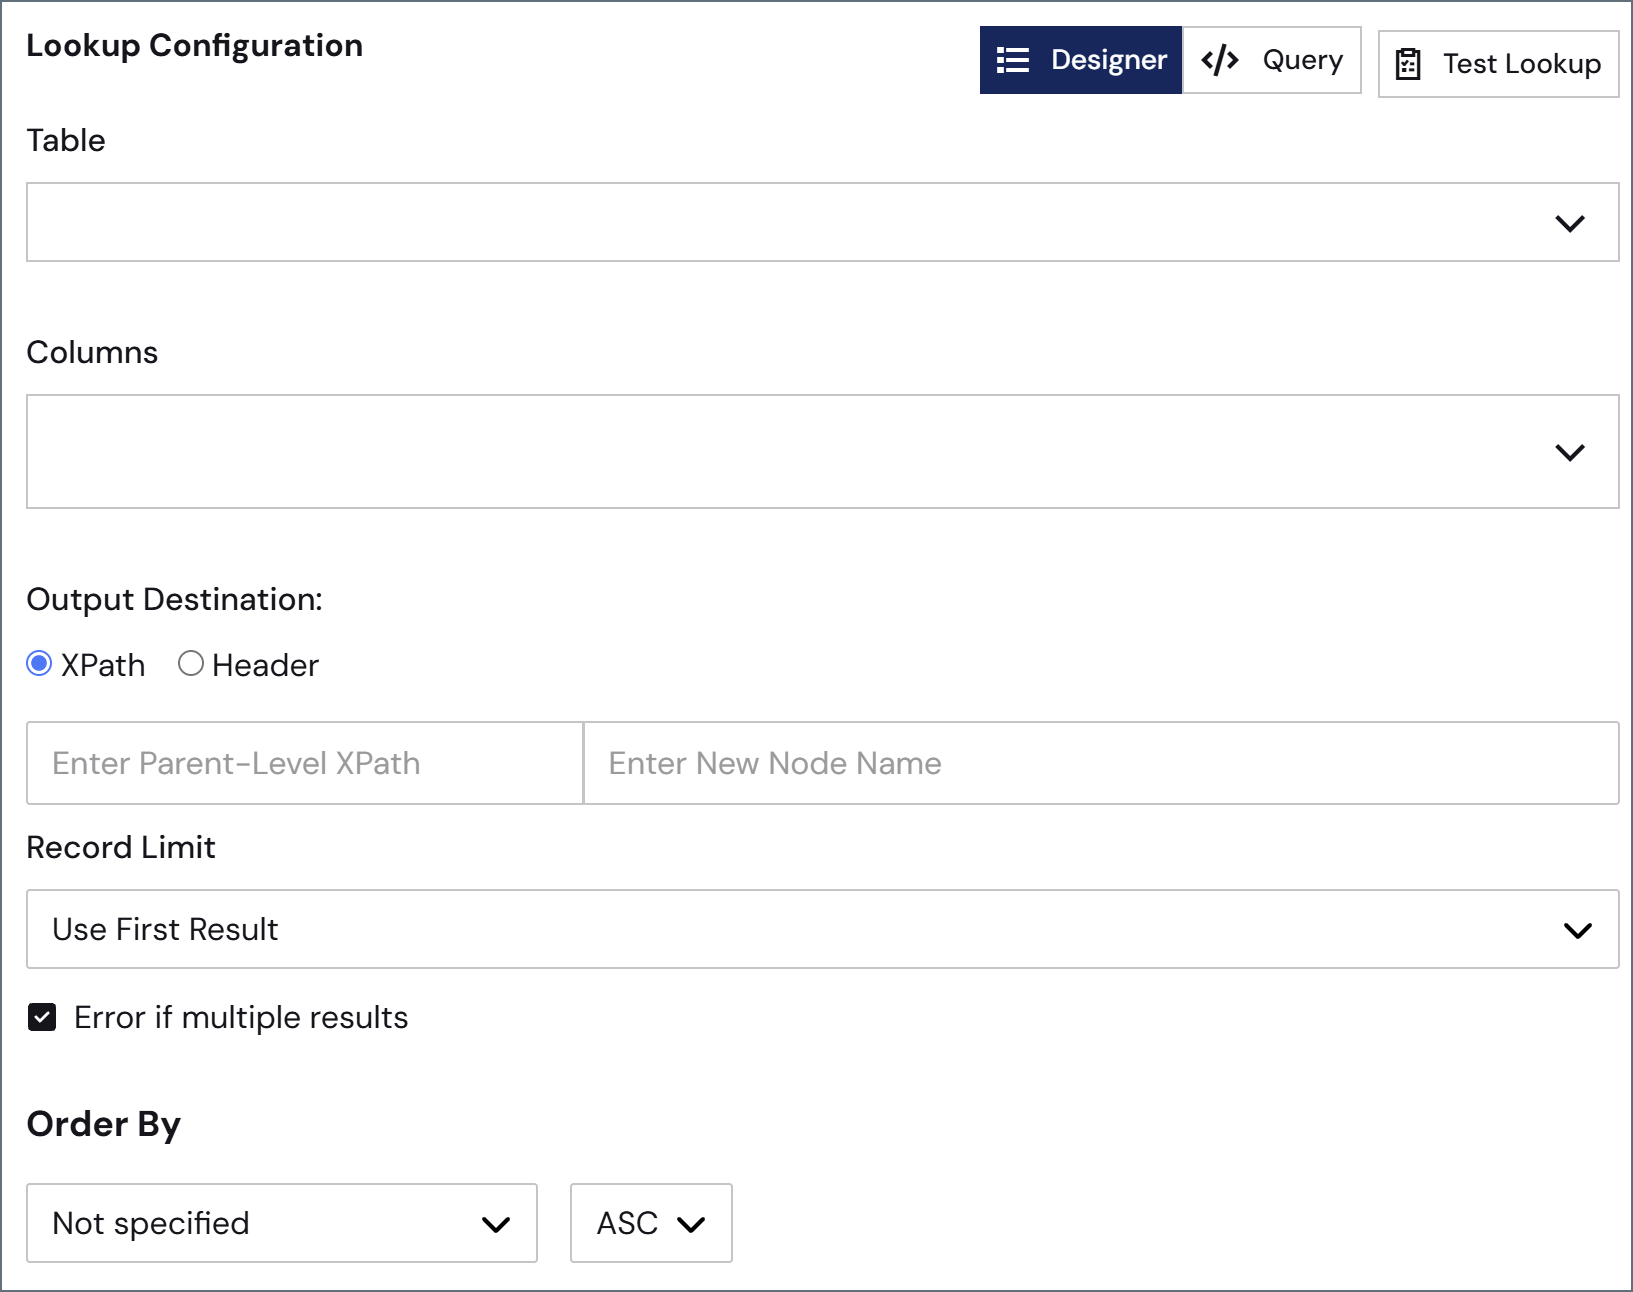
- **Table** ドロップダウンを使用して、含めるテーブルを選択します。
- このテーブルから含めたい**Columns** のセットを選択します。
- **Output Destination**:クエリの応答値をXML ファイルに挿入するには **XPath** を選択し、クエリの応答値をメッセージヘッダーに挿入するには **Header** を選択します。
- XPath:XPath を選択すると、デスティネーションは2つの部分に分かれます。**Parent-Level XPath** は、XML ドキュメントにすでに存在している必要があります。**New Node Name** は、ルックアップの結果を保持するためにXML ドキュメントに挿入されるノードの名前です。クエリの各カラムには、ここで提供されるXML 要素の中に独自のXML 要素(リーフレベル)があります。Parent-Level XPath には、兄弟条件で要素を指定するための[先読み構文](https://docs.arc.cdata.com/26.4/self-hosted/ja/mapping/mapping-node-value-editor.md#lookahead)を含めることができます。サンプルファイルをアップロードすると、先読みパスを構築しやすくなります。
- Header:Header を選択すると、コネクタはクエリのカラムごとに1つのヘッダーをアウトプットメッセージに追加します。値は、データベースから返されるレコードごとにカンマで区切られます。
- **Record Limit** を使用して、クエリが複数の結果を返した場合の処理を指定します。
- ドロップダウンで **Use First Result** を選択すると、**Error if multiple results** を使用して、複数の結果が返された場合にエラーを表示することができます。
- **Custom Limit** を選択すると、表示されるフィールドで制限値を指定する必要があります。
- **Order By** を使用して、結果を並べ替えるカラムを選択します。
- [フィルタ](#filters)セクションでは、インプットファイルからのヘッダーやXML への参照を含む、クエリのWHERE 句を作成するためのフィルタを作成できます。
### Filters
個々のフィルタやフィルタのグループを定義することで、複雑なフィルタを作成できます。見やすさのために、バーの右側にある展開アイコン  をクリックして、**Filters** セクションを展開します。
フィルタを追加するには、**Add Filter** または **Add Group** をクリックします。
フィルタを作成するときは、ドロップダウンを使用して選択を行い、演算子を選択します。次に、フィルタリングする値を指定します。以下から選択できます。
フィルタで**入力XML** を選択すると、サンプルファイルをアップロードした場合、エディタにドキュメントのツリー表示が現れるので、次の画像のように必要なXPath を簡単に見つけることができます。
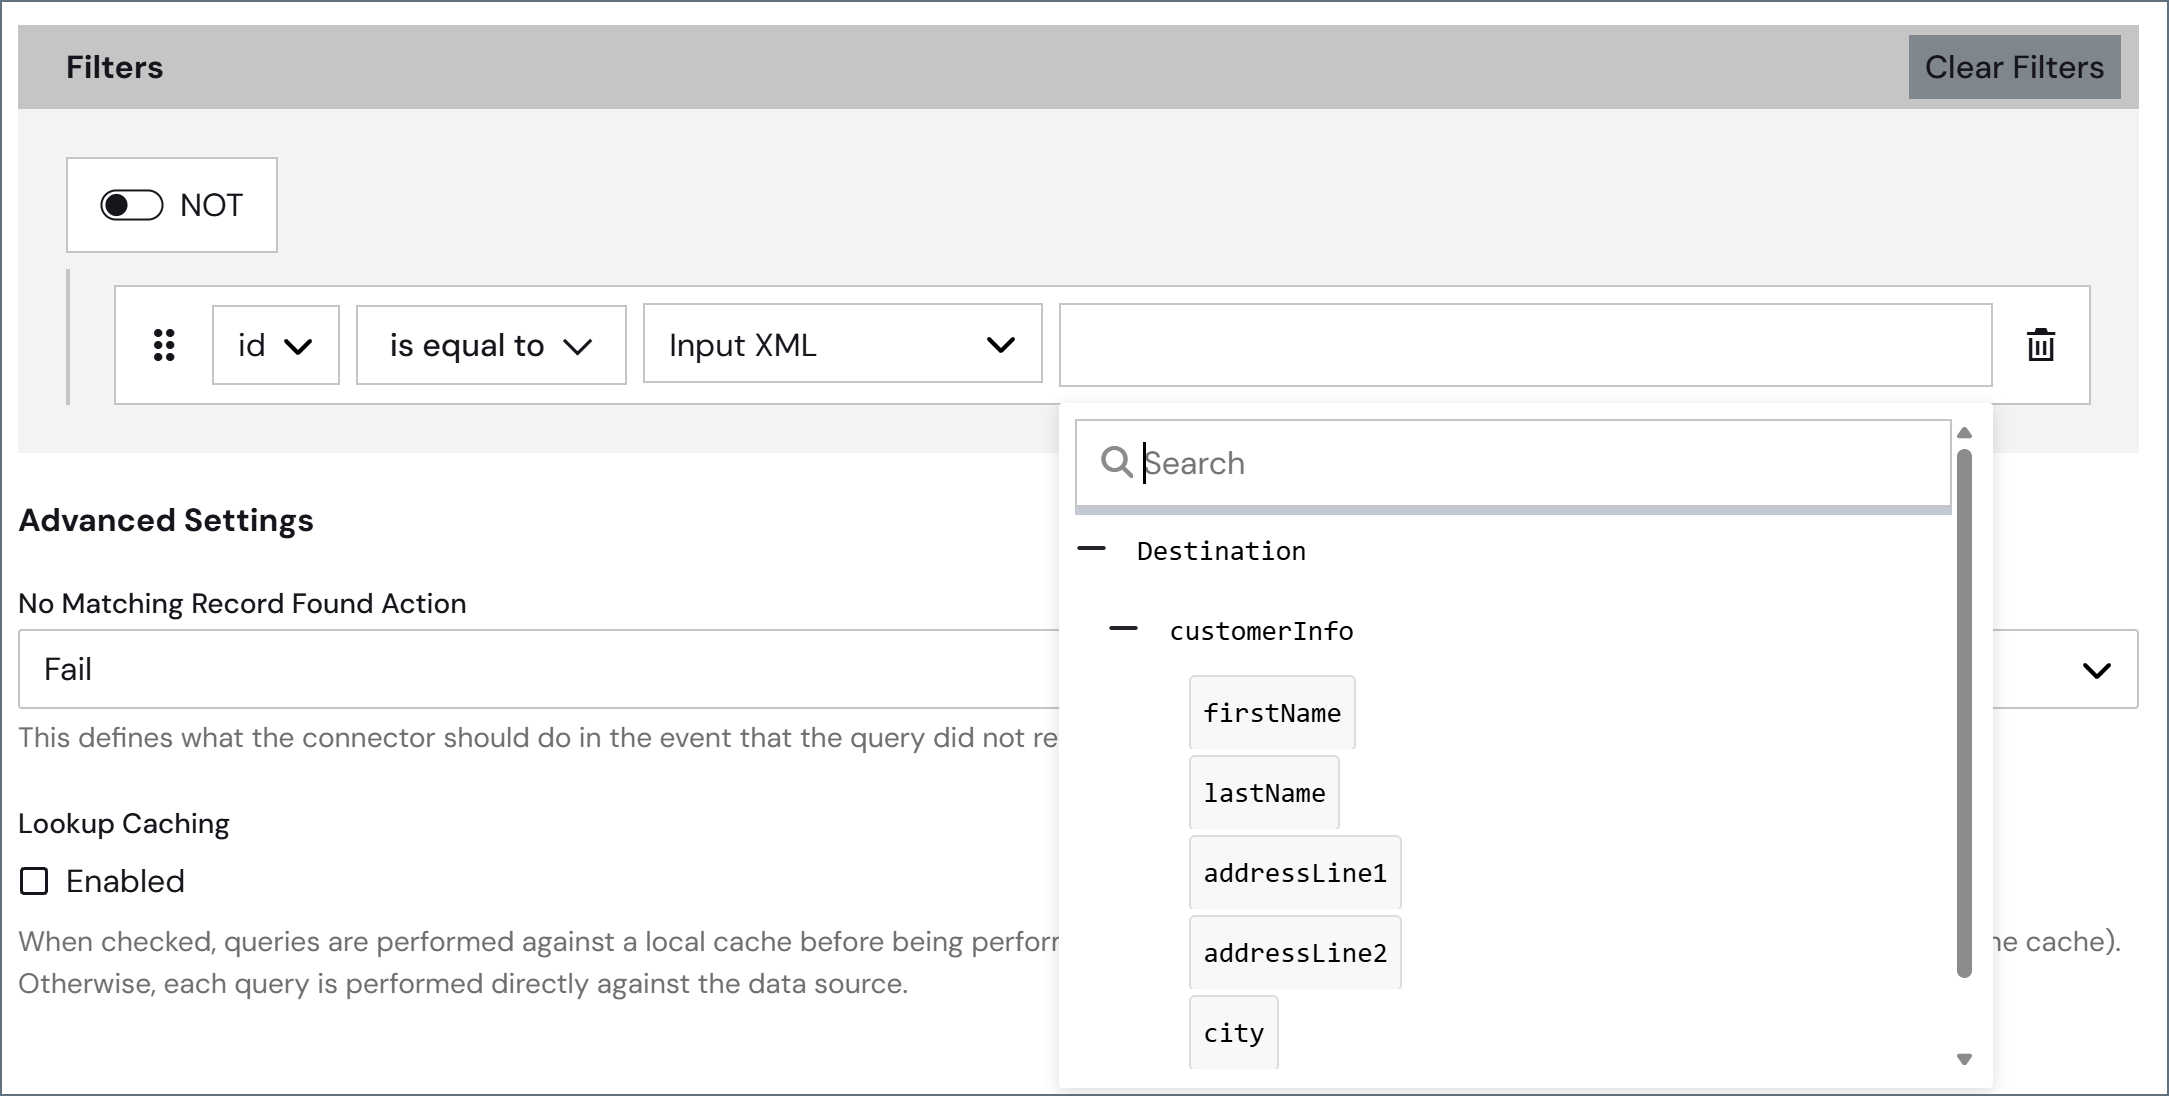
XPath には、兄弟条件で要素を指定するための[先読み構文](https://docs.arc.cdata.com/26.4/self-hosted/ja/mapping/mapping-node-value-editor.md#lookahead)を含めることもできます。これはEDI の修飾子と値のペアに便利です。例えば、`/Interchange/.../REF[REF01='IA']/REF02` は、兄弟のREF01 が `IA` と等しい場合にのみREF02 の値を対象とします。*xpath()* フォーマッタ内で使用されるバックスラッシュエスケープ形式とは異なり、ここでは角括弧をエスケープせずに入力します。
> [!NOTE]
>
> - \*\*サポートされる形式:\*\*存在チェック、等価チェック(子パス、属性、現在のテキスト、または引用符で囲まれたリテラルに対する)、およびAND で結合された複数の条件。単独の`[last()]` 位置セレクタもサポートされています。
> - \*\*サポートされない形式は、黙って別の解釈に置き換えられるのではなく拒否されます。\*\*Lookup がXPath を拒否した場合は、XPath を単純化してください。サポートされない形式には次のものがあります:任意のXPath 関数および演算子、同じノードに対する別の条件と組み合わせた`[last()]`、1つのパス内の複数の`[last()]` セレクタ、同じノードに対する別の条件と組み合わせた数値セレクタ、および末端の属性に直接付加された条件(代わりに親フィルタとして書き換えてください。例:`/actor[@type='lead']/@type`)。
> - \*\*パフォーマンス:\*\*先読み構文を使用すると、Lookup はドキュメントをストリーミングする代わりにメモリに読み込むため、より多くのメモリを使用します。非常に大きなXML インプットの場合は、先読みを使用しないXPath、または数値位置を使用するXPath を使用するか、Lookup をストリーミングモードに保つためにインプットを事前に処理することをお勧めします。
フィルタやグループは並べ替えが可能です。ハンドル  をクリックし、オブジェクトを新しい位置にドラッグします。
### Query Mode
以下の手順に従い、クエリモードを使用して Stripe コネクタのLookup アクションを設定します。
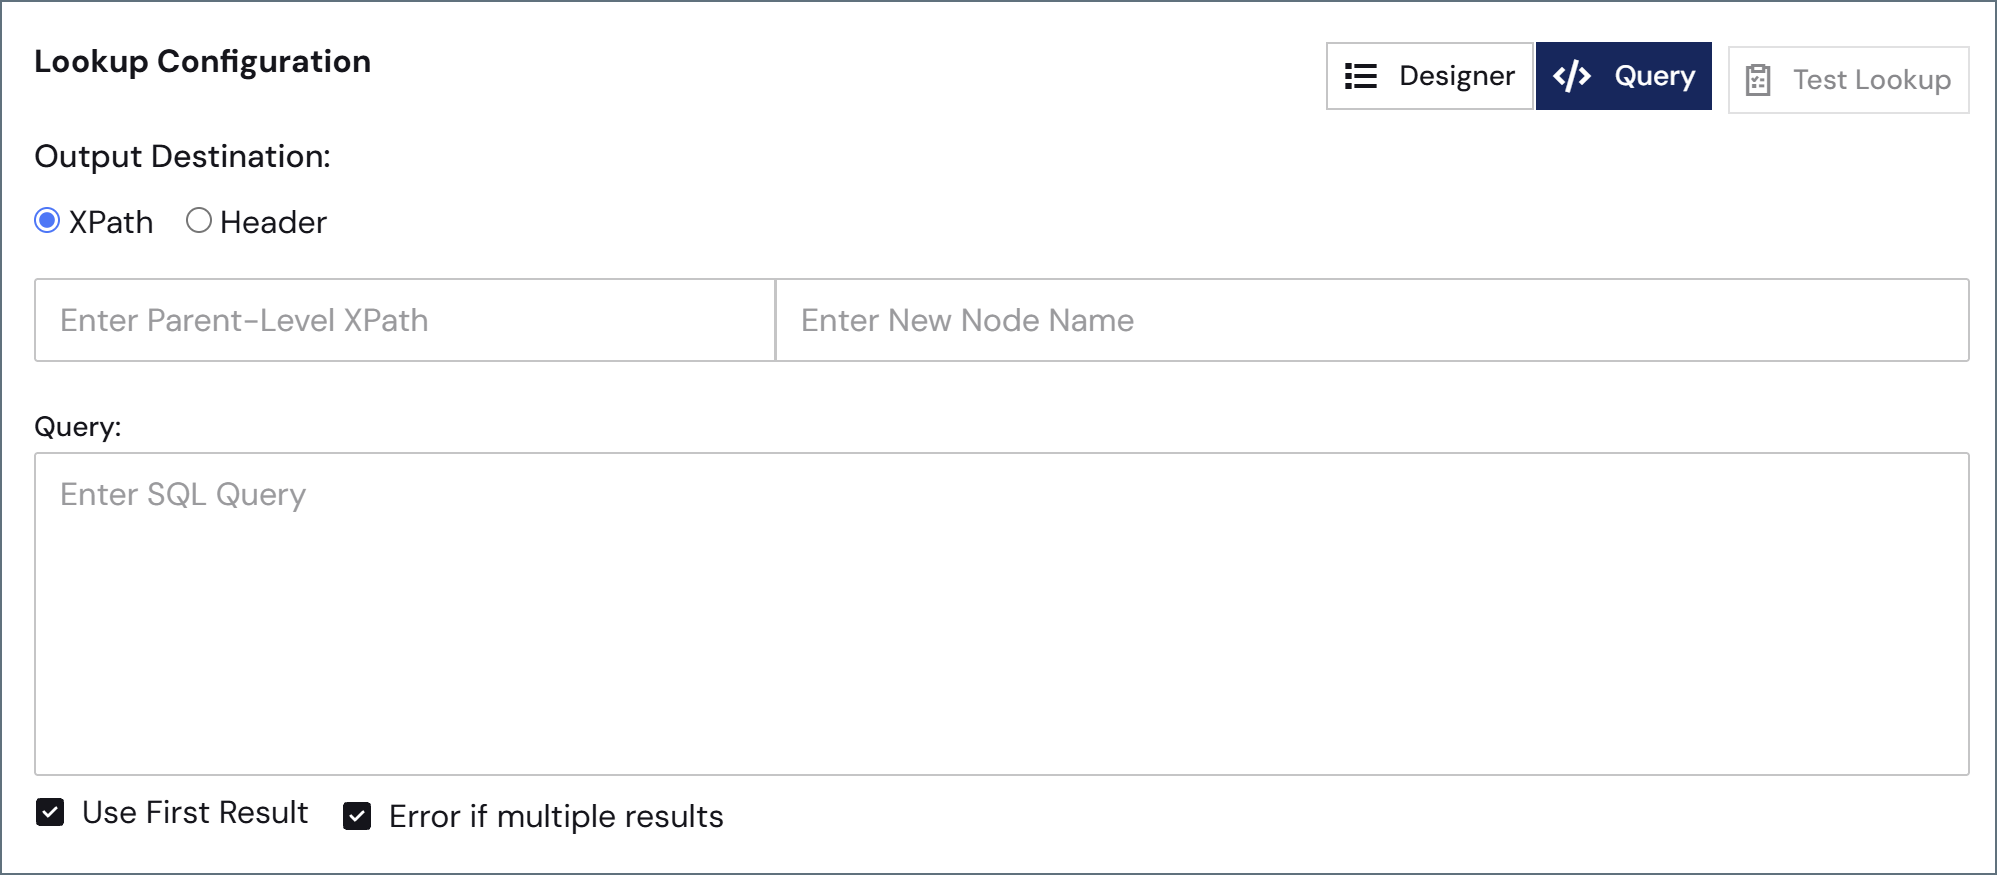
- **Output Destination**:クエリの応答値をXML ファイルに挿入するには **XPath** を選択し、クエリの応答値をメッセージヘッダーに挿入するには **Header** を選択します。
- XPath:XPath を選択すると、デスティネーションは2つの部分に分かれます。**Parent-Level XPath** は、XML ドキュメントにすでに存在している必要があります。**New Node Name** は、ルックアップの結果を保持するためにXML ドキュメントに挿入されるノードの名前です。クエリの各カラムには、ここで提供されるXML 要素の中に独自のXML 要素(リーフレベル)があります。Parent-Level XPath には、兄弟条件で要素を指定するための[先読み構文](https://docs.arc.cdata.com/26.4/self-hosted/ja/mapping/mapping-node-value-editor.md#lookahead)を含めることができます。サンプルファイルをアップロードすると、先読みパスを構築しやすくなります。
- Header:Header を選択すると、コネクタはクエリのカラムごとに1つのヘッダーをアウトプットメッセージに追加します。値は、データベースから返されるレコードごとにカンマで区切られます。
- **Query** に、Stripe テーブルからデータを取得するSQL クエリを入力します。
- XPath:パスを `${XPATH:/path/to/element}` のように記述します。例:`SELECT CustomerID FROM Customers WHERE CustomerName = ${XPATH:/Items/Invoices/Customer}`。XPath には、兄弟条件で要素を指定するための先読み構文を含めることもできます。例えば、`${XPATH:/Interchange/.../REF[REF01='IA']/REF02}` は、兄弟のREF01 が `IA` と等しい場合にのみREF02 の値を対象とします。サポートされる先読みの形式とパフォーマンスに関する考慮事項については、[フィルタ](#filters)を参照してください。
- Header:パスを `${HEADER:HeaderName}` のように記述します。
- 2つのチェックボックスで、クエリが複数の結果を返した場合の処理を設定できます。
- 常に最初の結果を使用するには、**Use First Result** をオンにします。
- 複数の結果が返された場合にエラーを表示するには、**Error if multiple results** をオンにします。
## Advanced

- **No Matching Record Found Action** を使用して、クエリに一致するレコードが見つからなかった場合の動作を指定します。
- Stripe コネクタは、各Lookup に対して直接 Stripe にクエリする代わりに、ローカルキャッシュに対してLookup クエリを実行できます。これにより、特に大規模なデータベースでクエリのパフォーマンスが向上します。これを有効にするには、**Lookup Caching** で**Enabled** を選択し、残りのフィールドを設定します。
- **Lookup Cache Provider**:キャッシュデータベースへの接続を容易にするために使用するドライバーを選択します。
- **Lookup Cache Connection String**:設定すると、コネクタはここで指定したデータベースをキャッシュに使用します。
- **Lookup Cache Tolerance**:コネクタがデータソースにクエリを発行してキャッシュをリフレッシュする頻度を制御します。
- **Lookup Cache Tolerance Unit**:**Lookup Cache Tolerance** の単位。分、時、日から選択します。
- **Reset Cache**:キャッシュされたすべてのデータを消去し、次回のLookup 時にコネクタが Stripe に再度クエリするようにします。
> [!NOTE]
>
> - クエリがキャッシュから結果を返さない場合、コネクタは Stripe を直接クエリします。
> - クエリステートメントに `limit`、`offset`、`groupby` パラメータが含まれている場合、キャッシュ機能は動作しません。これらのクエリは Stripe に直接送られます。
## Test Lookup
**Test Lookup** ボタンを使用すると、手動でファイルを処理することなく
設定をチェックして結果を確認できます。**Save Sample Data** ボタンを使用すると、
アウトプットをサンプルとして保存し、後のフローでマッピングすることができます。
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.