> ## Documentation Index
> Fetch the complete documentation index at: https://docs.arc.cdata.com/llms.txt
> Use this file to discover all available pages before exploring further.
# DB2 Advanced Configuration
> Reference for advanced settings available on the DB2 connector's Advanced tab.
**高度な設定**タブでは、DB2 コネクタの高度なプロパティを設定できます。以下のセクションでは、次の機能と設定について詳しく説明します。
- [XML モデル](#xml-models)
- [子テーブル](#child-tables)
- [高度なレコード選択](#only-process-new-or-changed-records)
- [前処理および後処理クエリ](#pre-processing-and-post-processing-queries)
- [XML 属性](#xml-attributes)
**高度な設定**タブのその他の多くの設定は、使用しているデータソースから動的に読み込まれるため、このドキュメントでは扱いません。データソース固有でない設定については、[高度な設定タブ](#advanced-tab)で説明しています。
データソースの*すべて*の設定に関する詳細情報は、CData Web サイトの[オンラインヘルプファイル](https://www.cdata.com/kb/help/)ページで確認できます。このページから、お使いのデータソースのタイルをクリックしてください。
> [!TIP]
>
> アプリケーション内の任意のフィールドにカーソルを合わせると、そのフィールドの機能に関する詳細情報がツールチップに表示されます。
## XML Models
DB2 コネクタは、CData Arc 内で DB2 のテーブルを XML としてモデル化します。モデル化は次の構造に従います。
* 親要素は、挿入先のテーブルを識別します。
* 各子要素は、対象テーブルのカラムに対応します。
これにより、XML 要素と DB2 の値とのつながりが確立され、コネクタは受信した XML ドキュメントから値を読み取り、それを INSERT または UPDATE クエリで使用できるようになります。
テーブルの XML モデルは、設定ペインの上部にある **`` Code** をクリックすると確認できます。次の XML は、XML 要素 `` としてモデル化された **Account** という名前のテーブルの簡略化されたモデル例です。
```xml theme={null}
```
上記の例では、`Id`、`account_c`、`AccountNumber`、`AccountSource` は **Account** テーブルのカラムです。コネクタがこの構造に一致する XML ファイルを処理すると、その XML の値が自動的に **Account** テーブルに挿入されます。コネクタが **Account** テーブルをクエリすると、この構造に一致する XML を出力します。
### Batching Input
DB2 コネクタは、大量のデータを挿入する際のパフォーマンスを向上させるためにバッチ処理をサポートしています。バッチ処理は、**高度な設定**セクションにある2つのフィールド、**TransactionSize** および **BatchInputSize** で設定します。これらのフィールドに正の整数を設定すると、コネクタは1回の操作(バッチ)で \[*BatchInputSize*] 件のレコードを挿入し、1回の接続(トランザクション)で \[*TransactionSize*] 件のレコードを挿入します。
XML 入力ファイルには、1回のトランザクションサイズを超えるレコードを含めることができます。その場合、コネクタは複数のトランザクションに分けてデータを挿入します。
バッチ挿入中にエラーが発生した場合、コネクタはトランザクションをロールバックし、失敗したトランザクション内の最初のレコードのインデックスをキャッシュします。入力ファイルが再試行されると、キャッシュされたインデックス以降のレコードのみが DB2 に挿入されます。
### Batching Output
アウトプットをクエリする際、複数のレコードを1つのドキュメントにまとめてバッチ処理するようにコネクタを設定できます。**最大レコード数**設定は1つのメッセージに含めるレコード数を制御し、**バッチサイズ**設定は1つのバッチグループに含めるバッチメッセージの数を指定します。
## Child Tables
DB2 コネクタは、1つのアクションで複数のテーブルをアップサートおよび選択(Select)することをサポートしています。複数のテーブルを含むテーブルモデルを作成する場合、テーブル同士は、一方のテーブルがもう一方のテーブルの子となる外部キーのリレーションシップを持つ必要があります。
子テーブルとやり取りするには、親テーブルを対象とするモデルを作成し、右側の矢印を使用して子テーブルを追加します。次の画像はUpsert アクションを示しています。
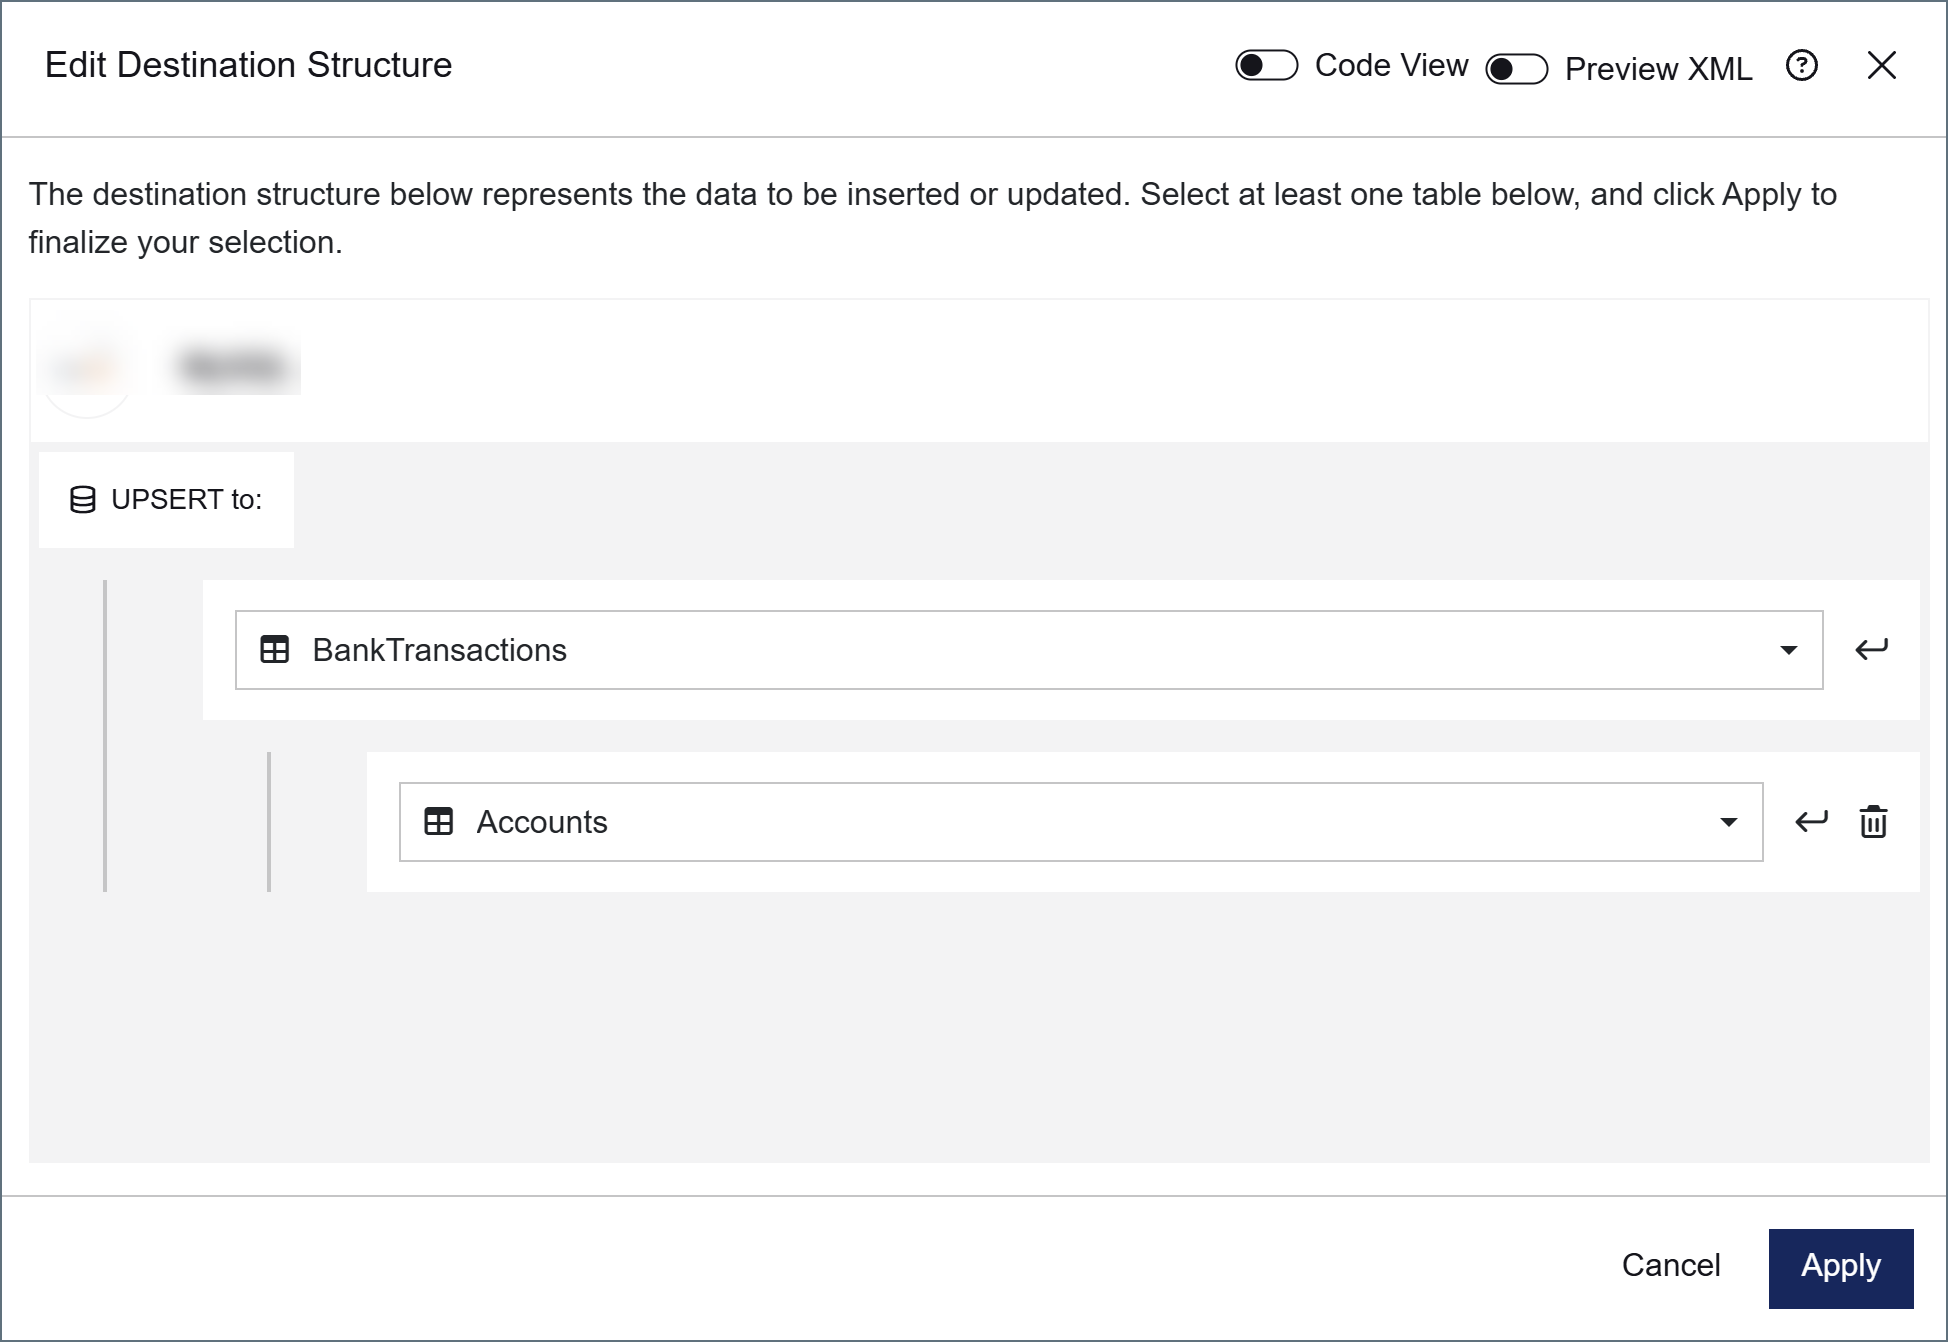
**Apply** をクリックすると、デザイナーがテーブルの階層構造を設定します。モデルに含める子テーブルのカラムを選択してください。
### Child Table XML
親テーブルと子テーブルに挿入する場合、入力マッピングの XML 構造は多層的になります。次の XML スニペットは、外部キーで関連付けられた2つのテーブルの入力マッピング例です。
```xml theme={null}
```
上記の例では、`Account` が親テーブルで、`AccountPartner` が子テーブルです。DB2 コネクタがこの構造に一致する入力 XML ファイルを処理すると、両方のテーブルを更新し、2つのレコードを関連付けるキーが同一になるようにします。
### Using the ref Attribute
子テーブルの一部のカラムには [ref](#ref) タグが付けられています。このタグは、これらのカラムが親テーブルの主キーに対応していることを示します。コネクタは、親テーブルへの挿入を行った後、子テーブルへの挿入を行う前に、たった今挿入したレコードの主キーを親テーブルにクエリします。コネクタは、子テーブルに挿入する際にこの値を使用します。
これは、親テーブルの主キーが DB2 によって生成される場合に便利です。この場合、このカラムは入力 XML として渡されないため、コネクタは親テーブルにレコードを挿入するまでそのカラムの値を知ることができません。
XML モデルにおいて、`ref` 属性は、カラムが後で参照できること、またはカラムの値がマッピング内の別のカラムから読み取られるべきことを示します。DB2 によって生成されるカラムの値を参照するには、カラム要素に予約値 `LAST_INSERT_ID` を設定した `ref` 属性を含める必要があります。
```xml theme={null}
-
```
これは、*id* の値が挿入後に取得され、後で(通常は子テーブルで)参照できることを示します。この値を後で参照するには、`ref` 要素に該当するカラムの名前を設定します。
```xml theme={null}
```
上記の例では、*id* は親テーブルの主キーの名前であり、子テーブルのカラムの名前でもあります。この `ref` 構文は、挿入後に親テーブルから *id* を取得し、取得した値を子テーブルの *id* カラムとして使用するようコネクタに指示します。
### Selecting From Child Tables
通常、親テーブルと子テーブルから選択(Select)する場合、子テーブルからレコードを取得するのは、外部キーが親テーブルの主キーと一致する場合のみとすべきです。
例として、**PurchaseOrders** 親テーブルと **PurchaseOrderLineItems** 子テーブルから発注データを取得する Select を考えてみます。**PurchaseOrders** から取得される各レコード(注文)は、その注文に関連付けられた明細項目も取得すべきです。この2つのテーブルは、共有された *PONumber* カラムによって関連付けられており、これは **PurchaseOrders** テーブルの主キーであり、**PurchaseOrdersLineItems** テーブルの外部キーです。明細項目のレコードを子テーブルから取得するのは、明細項目の *PONumber* が親テーブルから取得される注文の *PONumber* と一致する場合のみとすべきです。
Arc でこのリレーションシップを確立するには、Select に新しいフィルタを追加し、次のように設定します。
- 左側のドロップダウンで、親テーブルへの外部キーである子テーブルのカラムを選択します。上記の例では、これは **PurchaseOrderLineItems** テーブルの *PONumber* カラムです。
- 中央の(演算子の)ドロップダウンで、**equal** を選択します。
- 右側の入力ボックスで、まず右にあるドロップダウンの矢印を使用して **REF** を選択します。その後、入力ボックスには `$` プレフィックスが付き、親テーブルを参照していることを示します。
- 右側のドロップダウンを使用して、子テーブルの外部キーと一致させる親テーブルのカラムを選択します。上記の例では、これは **PurchaseOrders** テーブルの *PONumber* カラムです。
## Only Process New or Changed Records
Select アクションは、最近更新または追加されたレコードのみを取得するように設定できます。コネクタは、どのレコードが新規または変更されたかを検出するために2つの方法を使用できます。
- 1つ目の方法では、レコードの最終更新日時を表す DateTime カラムが必要です。
- 2つ目の方法では、レコードを処理すべきかどうかを表す値を明示的に格納するカラムが必要です。
どちらのオプションも、**設定**タブの設定パネル下部にある**高度な設定**で設定します。要件をさらに細かく調整するには、**高度な設定**タブの[高度な設定](#advanced-settings)部分にある3つの追加の **Process Changes...** 設定を参照してください。
### Using a Last Modified Column
テーブルに DateTime カラムが含まれている場合、**高度な設定**セクションに **新規または変更されたレコードの処理にカラムを使用する** チェックボックスが表示されます。これを、レコードの最終更新日時を表す DateTime カラムに設定します。
### Using a Custom Column
Select アクションは、DB2 から正常に取得されたレコードについて、テーブル内のカラムを更新するように設定できます。これを、まだ取得されていない(または再度取得すべき)ことを示すカラム値を持つレコードのみを選択するフィルタルールと組み合わせることができます。
処理後のカラム更新を有効にするには、**高度な設定**セクションの **行が正常に処理されたときにカラムを指定の値で更新する** チェックボックスを使用し、更新するカラムと、そのカラムに設定する値を指定します。
例えば、レコードを取得した後に *Processed* カラムを **1** に更新するようにアウトプットマッピングを設定できます。そして、*Processed が 1 と等しくない* レコードのみに制限する **フィルタ** ルールを適用できます。
この例では、コネクタが Select テンプレートを処理すると、テンプレートに基づいて SELECT ステートメントを作成します。テンプレートは `SELECT Id, AccountId, Amount FROM INVOICE` を実行し、テンプレートに基づいて結果セット内の各レコードについて XML ファイルを作成し、それらのファイルをこのコネクタのアウトプットフォルダに配置します。
## Pre-Processing and Post-Processing Queries
DB2 コネクタは、設定したアクションを実行する前後に追加のクエリを実行するように設定できます。これらの追加クエリを設定するには、コネクタが生成するクエリコードを手動で変更する必要があります。以下のセクションでは、その手順を説明します。
### In Upsert Mappings
Upsert マッピングでは、テーブルにすべてのレコードがアップサートされる前または後に自動的に実行されるクエリを発行できます。
この機能を設定するには、まず **Upsert Configuration** ペインで **`` Code** をクリックします。

これにより、テーブルマッピングの高度な設定を編集できるテキストエディタが開きます。エディタ内のテキストは、次のスニペットのようになります。
```xml theme={null}
…
```
テーブルにカラムを追加する前または後にクエリを発行するには、次の属性を持つ要素を定義します。
* `requireInput`: `false` に設定します。この属性値は、入力ファイル内に一致する入力要素がなくてもクエリを発行するようコネクタに指示します。
* `insertQuery`: UPSERT クエリの前または後に実行したいクエリを格納します。
* `table`(任意): 追加クエリの対象にしたいテーブルの名前を設定します。(以下の例では、テーブル名は updateTable です。)マッピングのルートレベル、つまり `` 要素の子としてクエリを発行する場合、この属性は必要ありません。別のテーブルの子としてクエリを発行する場合は、table 属性を設定することで、そのクエリがそのテーブルのカラムと区別されるようになります。
新しく定義した要素を、実行したいタイミングに応じて UPSERT クエリの前または後に配置します。
次の例では、`` 要素が、テーブルへの UPSERT リクエストの前にクエリ `EXEC [dbo.FlushTemp]` を実行します。
```xml theme={null}
…
```
次の例では、`` 要素が、テーブルへのすべての UPSERT リクエストが完了した後にクエリ `EXEC [dbo].[CommitTemp]` を実行します。
```xml theme={null}
…
```
要素名 `runFirst` および `runLast` はプレースホルダです。要件に合わせて変更できます。
> [!NOTE]
>
> Upsert マッピングにおける前処理クエリおよび後処理クエリは、クエリ内にハードコードされていない入力要素を受け付けず、また出力データを生成しません。
### In Select Mappings
Select マッピングでは、対象テーブルへのクエリ発行の前後に自動的に実行されるクエリを発行できます。この機能を設定するには、まず **Select Configuration** ペインで **`` Code** をクリックします。

これにより、テーブルマッピングの高度な設定を編集できるテキストエディタが開きます。
テーブルにカラムを追加する前または後にクエリを発行するには、次の属性を持つ要素を定義します。
* `outputResult`: `false` に設定します。この属性値は、クエリの結果として出力ファイルにデータを返さないようコネクタに指示します。
* `selectQuery`: SELECT クエリの前または後に実行したいクエリを格納します。
* `table`(任意): 追加クエリの対象にしたいテーブルの名前を設定します。(以下の例では、テーブル名は selectTable です。)マッピングのルートレベル、つまり `` 要素の子としてクエリを発行する場合、この属性は必要ありません。別のテーブルの子としてクエリを発行する場合は、table 属性を設定することで、そのクエリがそのテーブルのカラムと区別されるようになります。
新しく定義した要素を、実行したいタイミングに応じて SELECT クエリの前または後に配置します。
次の例では、`` 要素が、テーブルに対して SELECT クエリが発行される前にクエリ `EXEC [dbo].[prepTable]` を実行します。
```xml theme={null}
…
```
次の例では、`` 要素が、テーブルに対して SELECT クエリおよびすべての子クエリが発行された後にクエリ `EXEC [dbo].[cleanTable]` を実行します。
```xml theme={null}
…
```
要素名 `runFirst` および `runLast` はプレースホルダです。要件に合わせて変更できます。
> [!NOTE]
>
> Select マッピングにおける前処理クエリおよび後処理クエリは、クエリ内にハードコードされていない入力要素を受け付けません。
## XML Attributes
Arc は、XML ドキュメントとデータベーステーブルの間でデータがどのように解釈、マッピング、変換されるかを定義する一連の XML 属性をサポートしています。これらの属性は、XML 構造全体、特定のテーブル、または個々のカラムなど、さまざまなレベルで適用でき、Arc がデータベースのデータをどのように読み取り、書き込み、整形するかを正確に制御できます。
### Table Attributes
テーブル属性は、Arc がデータベーステーブルとどのようにやり取りするかを定義し、取得するデータ、レコードの挿入や更新の方法、変更された行のみを処理するかどうかを指定します。[selectQuery](#selectquery)、[insertQuery](#insertquery)、[upsertQuery](#upsertquery)、[table](#table) といった属性はデータの取得および変更操作を制御し、[requireInput](#requireinput)、[outputResult](#outputresult)、[ProcessChangesOnly](#processchangesonly) といった設定は入力要件や出力の動作を決定します。
#### allColumns
Select マッピングでは、この属性を使って、出力 XML にクエリ結果で返されたすべてのカラムを含めるよう指定します。これにより、出力マッピングですべてのカラム名を明示的に定義することなく出力マッピングを定義できます。この属性がない場合、出力マッピングに存在するカラムを使って、クエリから返された要素がコードビューで指定された順序に配置され、クエリで返されたが一致するカラムを持たない要素は出力 XML に返されません。
``
#### insertQuery
Upsert マッピングでは、このクエリを使って、レコードが挿入される際にコネクタが作成するデフォルトのクエリを上書きできます。入力ファイルに関連付けられた通常の挿入を超えるクエリを発行するために使用できます。
``
#### outputResult
Select マッピングでは、この属性を設定すると、Select クエリに一致するクエリが、出力 XML に返されるコンテンツを生成せずに発行されます。これにより、コネクタの出力に反映されない追加のクエリを、トランザクションの一部として実行できます。
``
#### processChangesOnly
Select マッピングでは、processChangesOnly 属性をテーブルに適用し、あわせて [timeCheck](#timecheck) 属性を datetime カラムに適用すると、Select マッピングはこのカラムをクエリ内の動的に生成される WHERE 句で使用し、新しいレコードのみが取得されるようにします。これは、デザイナーの **新規または変更されたレコードの処理にカラム *columnname* を使用する** オプションで選択したカラムに対応します。詳細については、[新規または変更されたレコードのみ処理する](#only-process-new-or-changed-records)を参照してください。
> [!NOTE]
>
> これは Select マッピングのルートテーブルにのみ適用されます。
``
#### requireInput
Upsert マッピングでは、この属性を設定すると、inputQuery に一致するクエリが、入力 XML に一致する要素が含まれているかどうかに関係なく実行されます。これは、1 つ以上の入力要素が存在する同じトランザクションの一部として[前処理クエリまたは後処理クエリ](#pre-processing-and-post-processing-queries)を発行する場合に使用されます(たとえば、新しいバッチを投入する前にテーブルを切り詰めたり、バッチ完了後にストアドプロシージャを実行したりする場合など)。
``
#### selectQuery
Select マッピングでは、これを使って XML 内でクエリとそのパラメータを定義します。selectQuery が指定されていない場合は、単純な `SELECT *` が発行されます。JOIN やその他の SQL キーワードを使用するクエリなど、カスタムクエリに selectQuery を使用できます。
``
#### table
特にテーブル名が、それにマッピングされる有効な XML 要素と異なる場合に、マッピングされたクエリの対象となるテーブルを指定するために使用します。
> [!NOTE]
>
> selectQuery、upsertQuery、または insertQuery に明示的なクエリが記述されている場合、この属性は無視されます。
``
#### upsertQuery
Upsert マッピングでは、このクエリを使って、処理対象のレコードが新規レコード(INSERT)なのか、既存レコードの更新(UPDATE)なのかを判定します。このクエリに一致する結果が見つかるかどうかに基づいてアクションが決定されます。
``
### Column Attributes
カラム属性は、Arc ワークフロー内で個々のデータフィールドがどのように処理、変換、検証されるかを設定します。これらの属性により、データ型の定義、値の集約、経時的な変更の追跡、特定のカラムへのカスタム更新ロジックの適用が可能になります。
#### aggregate
場合によっては、マッピング内のカラムの値そのものが XML 集約であることがあります。デフォルトの動作では、カラムを文字列として扱い、XML エンコードを使ってカラム内の集約の値をエンコードします。しかし、aggregate 属性がカラムに存在する場合、テーブルにマッピングされる XML ファイルは、集約カラムの値を単一の要素にエンコードする代わりに、生の XML として保持します。
``
#### column
マッピング内のカラムにある column 属性は、参照されているテーブル内のカラムの名前を指定します。これにより、次のようなことが実現できます。
- 有効な XML 要素ではないカラムにマッピングする
- データベース内のカラムにエイリアスを作成し、別のテーブルにある同様の名前のカラムと区別する
- XML モデル内でより読みやすい要素を使用する
``
#### id
Select マッピングでは、この属性によってカラムの値に Id マーカーが付与され、後で子クエリ内から `${#ID}` という構文で参照できるようになります。これは、複数のテーブルに同名のカラムが存在し選択時にあいまいさが生じるような場面で、カラムの値を子クエリで使用したい場合に便利です。
```xml theme={null}
...
...
...
```
#### key
カラムをテーブルの主キーとして識別します。この属性が Upsert クエリに存在する場合、コネクタは更新する前にレコードが存在するかどうかを確認します。テーブルにこの属性が存在しない場合、そのテーブルには挿入のみが許可され、一意のレコードを識別する手段がないため、レコードを選択した後にカラムの値を更新することはできません。(既存のカラムをキーカラムと同じように使用できると確信できる場合は、そのカラムを上書きしてキーとして機能させることができます。)
``
#### ref
Upsert マッピングでは、この属性を使って、入力 XML だけでは決定できない値をデータベースにアップサートするために指定します。これは最も一般的には、親子関係においてデータベースが生成する主キーを決定する場合や、あるテーブルが子テーブル上の外部キー参照を使用する場合に利用されます。詳細については、[ref 属性の使用](#using-the-ref-attribute)を参照してください。
```xml theme={null}
...
...
```
#### timeCheck
Select マッピングでは、[processChangesOnly](#processchangesonly) 属性をテーブルに適用し、あわせて timeCheck 属性を datetime カラムに適用すると、Select マッピングはこのカラムをクエリ内の動的に生成される WHERE 句で使用し、新しいレコードのみが取得されるようにします。これは、デザイナーの **新規または変更されたレコードの処理にカラム *columnname* を使用する** オプションで選択したカラムに対応します。詳細については、[新規または変更されたレコードのみ処理する](#only-process-new-or-changed-records)を参照してください。
> [!NOTE]
>
> これは Select マッピングのルートテーブルにのみ適用されます。
``
#### type
テーブル内のカラムのデータ型を識別するために使用します。Upsert クエリの場合、クエリが実行される前に、カラム内の値に対して型が検証されます。
``
#### updateValue
Select マッピングでは、データベースから選択された各レコードは、取得後にこのカラムが新しい値で更新されます。これは、デザイナーの **行が正常に処理されたときにカラム *columnname* を値 *value* で更新する** オプションに対応します。
> [!NOTE]
>
> これはクエリのルートテーブルにのみ適用されます。
``
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.